Новые голоса, GPT Image 2.6 с GIF и обновлённые Claude и Gemini
Семь новых моделей озвучки, GIF и SVG в GPT Image 2.6, видео Omni 1.2 до 15 секунд, Claude Fable 5.2, GPT-6.1 Terra и Gemini 4 Carbon.
В NetRoom появились семь новых моделей озвучки. Заодно обновили текстовые модели OpenAI, Google и Anthropic, генераторы изображений GPT Image и видеомодель Gemini Omni. Всё доступно из одного аккаунта с общим балансом.
Семь новых моделей для озвучки
Теперь для чтения текста, роликов и голосовых сцен можно выбрать:
- Google Gemini 3.8 Flash TTS и Flash Lite TTS — по 30 готовых голосов и диалоги с двумя собеседниками. Подачу можно описать отдельно от текста: например, «спокойно, с теплотой, с паузой перед последней фразой».
- Microsoft MAI-Voice 2.1 Flash и MAI-Voice 2.1 — в том числе русские голоса Grant, Harper, Lev и Masha. Язык определяется выбранным голосом.
- Mistral Voxtral TTS 3 — готовые голоса и теги эмоций и темпа в тексте.
- AssemblyAI TTS 1 — ещё один вариант для повествования и голосовых приложений.
- Inworld Realtime TTS-2 — теги подачи, выбор голоса и регулировка скорости. Среди готовых голосов есть Светлана, Елена, Дмитрий и Николай.
У голосов появились короткие демо: их можно прослушать до генерации. Доступные настройки зависят от модели. У Gemini инструкции подачи вынесены в отдельное поле «Как озвучить» — вписывать их в произносимый текст не нужно.
Озвучка своим голосом
Клонирование доступно в Fish Audio S2.1 Pro, Fish Drama 3, HeyGen Voice и HeyGen Voice Turbo. В разделе «Звук» или студии выберите «Клонировать свой голос»: загрузите запись или запишите образец с микрофона, затем введите новый текст.
Для записи есть готовый текст — он автоматически заполнит расшифровку. У HeyGen расшифровку можно оставить пустой. Образец можно прослушать, заменить и использовать повторно: он сохраняется в этом браузере для вашего аккаунта и не теряется при смене совместимой модели.
Используйте собственный голос или голос человека, который согласился на его использование. После генерации проверьте произношение и сходство: результат зависит от записи и модели.
GPT Image 2.6: изображения, GIF и SVG
GPT Image 2.6 Flare и Sunburst заменили версии 2.5. Кроме JPG, PNG и WEBP, теперь можно выбрать GIF или SVG.
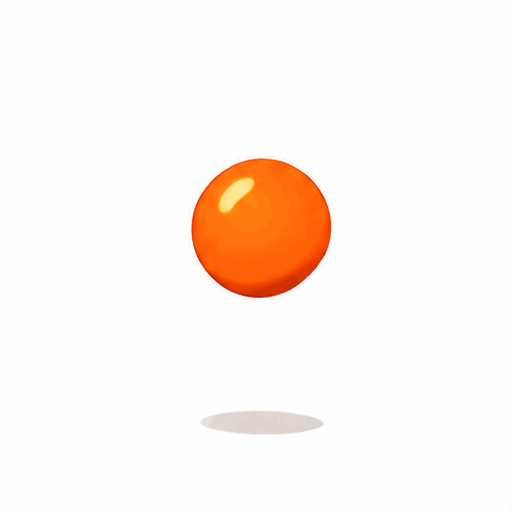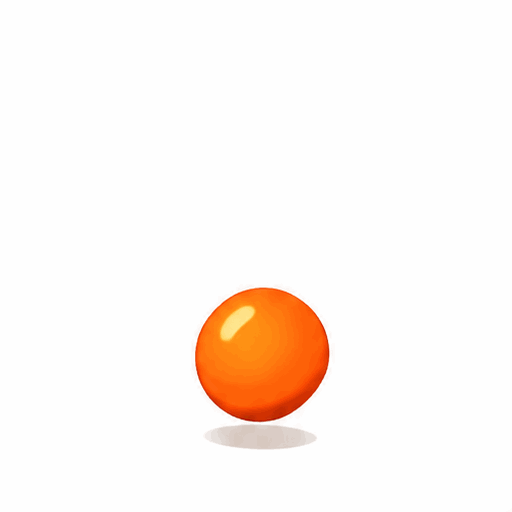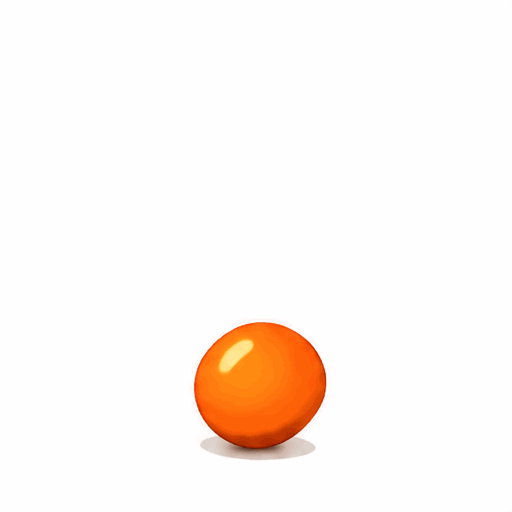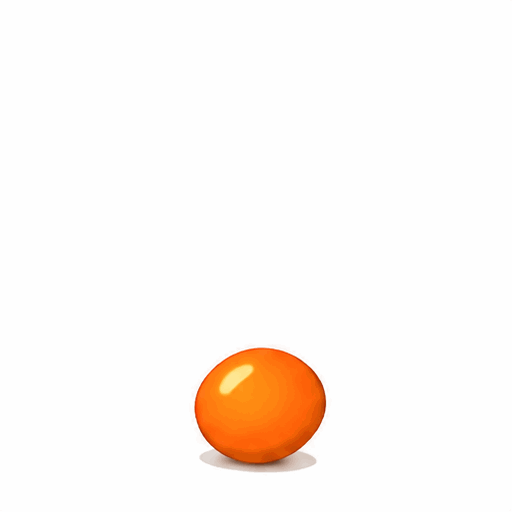
Для GIF опишите короткое повторяющееся движение и выберите формат GIF. Текущий режим создаёт 9 кадров по 0,2 секунды с бесконечным повтором. Размер кадра подбирается автоматически, до 960 пикселей на сторону. GIF и SVG генерируются из текста, без приложенных референсов.
Пример GIF, созданный при проверке обновления:
Omni Flash 1.2: видео до 15 секунд
Gemini Omni Flash 1.2 создаёт видео с нативным звуком из текста или одного начального кадра длительностью до 15 секунд. Если используются референсы или пара первого и последнего кадров, предел — 10 секунд. Поддерживается вывод до 4K.
Новые текстовые модели
Claude Fable 5.2 пришёл на смену Fable 5. Добавили GPT-6.1 Terra, Terra Pro и Gemini 4 Carbon.
Terra подходит для повседневного кода, текстов и агентных задач. Terra Pro использует усиленное рассуждение: тариф за токен тот же, но ответ может занять больше времени и потребовать больше токенов. Fable 5.2 и Carbon дополняют выбор моделей для сложного анализа, кода и документов.
Как считается стоимость
Цены в каталоге озвучки обновлены по текущим тарифам. У большинства голосовых моделей расчёт идёт по объёму входного текста; у Gemini TTS — по входным текстовым и выходным аудиотокенам. Поэтому цена перед запуском — оценка, а окончательная стоимость зависит от генерации.
Новые модели уже доступны в приложении. Открыть каталог моделей или перейти к генерации.